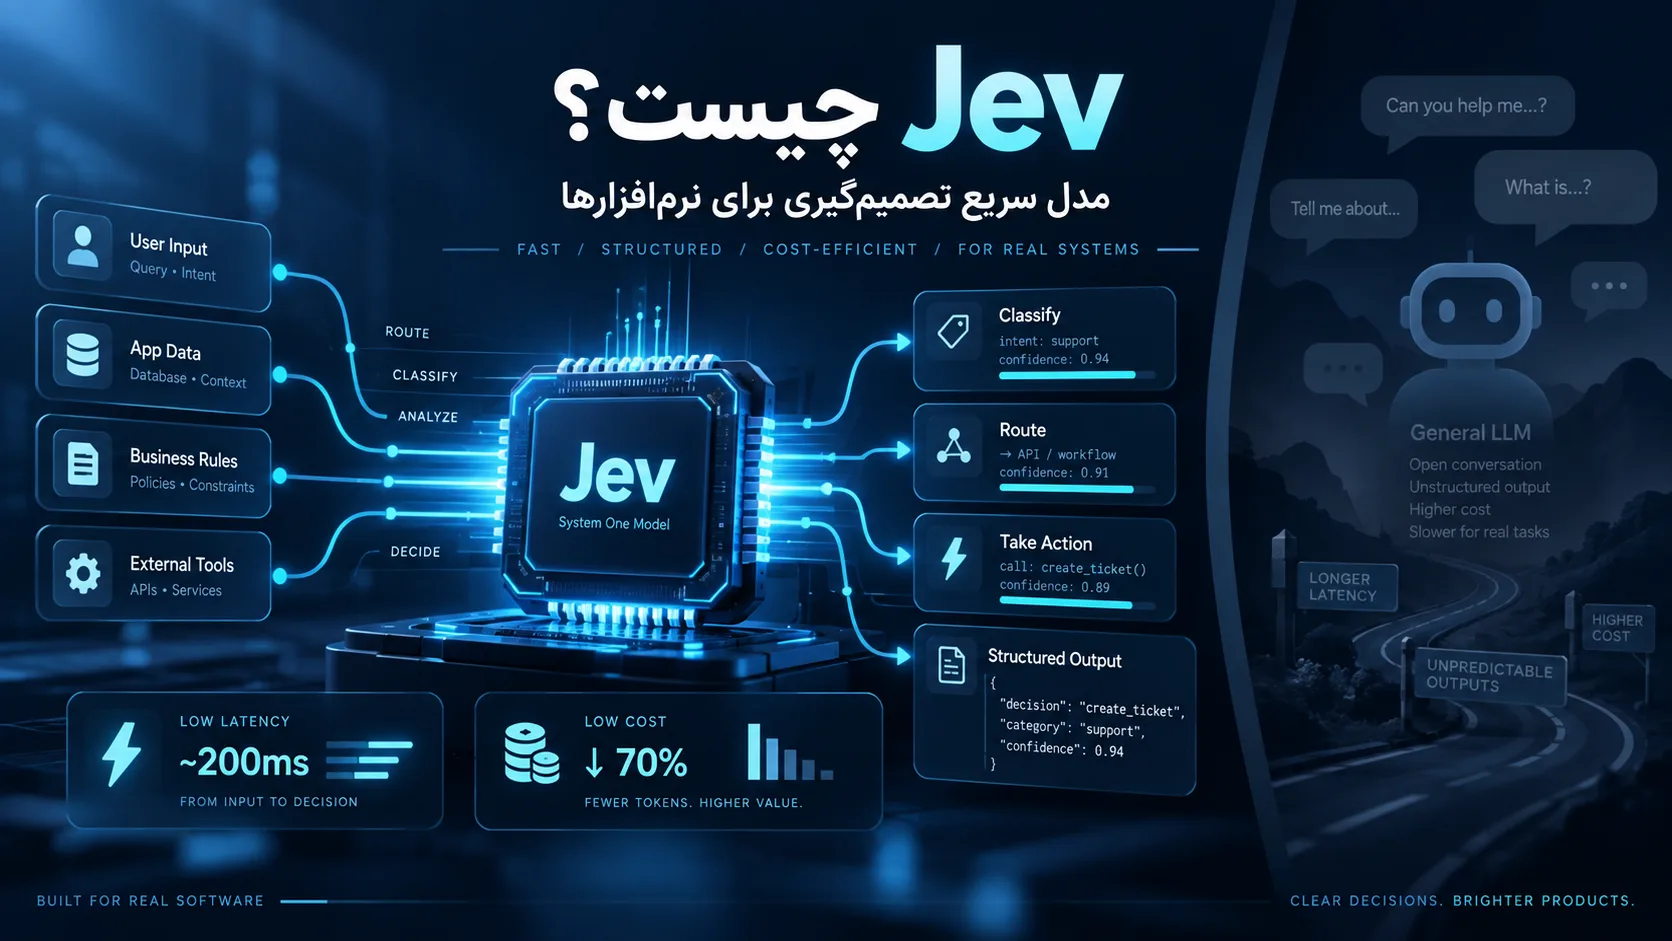
در چند روز اخیر نام یک مدل هوش مصنوعی جدید به نام Jev در شبکههای اجتماعی حسابی سر و صدا کرده است.
تیترهایی مثل «۲۰۰ برابر سریعتر از ChatGPT»، «۴۰۰ برابر ارزانتر از Claude» و حتی ادعاهایی درباره تغییر کامل آینده هوش مصنوعی باعث شده Jev خیلی سریع مورد توجه قرار بگیرد.
اما سؤال مهم این است: Jev واقعاً چیست و چقدر از این ادعاهای جنجالی حقیقت دارد؟
در این مقاله از معین گیفت بدون هیجانزدگی تبلیغاتی بررسی میکنیم Jev چگونه کار میکند، چرا با ChatGPT و Claude تفاوت بنیادی دارد و اعداد عجیب مربوط به سرعت و هزینه آن دقیقاً به چه معنا هستند.
Jev چیست؟
Jev اولین مدل عمومی شرکت TypeSafe AI از خانوادهای است که این شرکت آنها را System One Models مینامد.
این مدل در سپتامبر ۲۰۲۶ معرفی شد و برخلاف مدلهایی مانند ChatGPT و Claude برای تولید متن طولانی، مکالمه یا نوشتن مقاله ساخته نشده است.
هدف Jev بسیار مشخصتر است:
گرفتن تصمیمهای سریع، ساختاریافته و قابل استفاده مستقیم داخل نرمافزار.
یعنی بهجای اینکه Jev یک پاراگراف توضیح بدهد، معمولاً باید بین چند گزینه از قبل تعریفشده انتخاب کند و برای هر گزینه احتمال یا Confidence ارائه دهد.
TypeSafe AI را چه کسی ساخته است؟
TypeSafe AI توسط Diogo Almeida و تیمی از پژوهشگران هوش مصنوعی تأسیس شده است.
Almeida پیش از این در OpenAI فعالیت داشته و در پروژههای مربوط به InstructGPT، RLHF و توسعه سیستمهای اولیه ChatGPT نقش داشته است.
او در سال ۲۰۲۴ OpenAI را ترک کرد و TypeSafe AI را با این ایده راهاندازی کرد که مدلهای فعلی هوش مصنوعی برای «گفتوگو» بسیار خوب شدهاند، اما هنوز برای تصمیمگیری کاملاً خودکار داخل نرمافزارها ایدهآل نیستند.
Jev نتیجه حدود دو سال توسعه مخفیانه این ایده است.
System One Model یعنی چه؟
نام System One از مفهوم معروف Thinking, Fast and Slow گرفته شده است.
در این تقسیمبندی، System 1 به تصمیمگیری سریع و شهودی اشاره دارد، در حالی که System 2 نماینده تفکر آهستهتر و تحلیلیتر است.
TypeSafe از این مفهوم برای نامگذاری مدلهای خود استفاده کرده است.
البته باید توجه داشت که System One Model یک استاندارد عمومی و پذیرفتهشده در صنعت هوش مصنوعی نیست و نامی است که خود TypeSafe برای این معماری انتخاب کرده است.
Jev دقیقاً چه کاری انجام میدهد؟
فرض کنید یک سیستم پشتیبانی مشتری دارید.
یک پیام جدید وارد میشود:
سفارشم دو هفته است نرسیده و میخواهم مبلغ را پس بگیرم.
یک مدل زبانی معمولی ممکن است متن را تحلیل کند و چند جمله درباره مشکل کاربر بنویسد.
اما نرمافزار شما شاید فقط به چند تصمیم نیاز داشته باشد:
- نوع درخواست چیست؟
- اولویت آن چقدر است؟
- به کدام تیم ارسال شود؟
- آیا نیاز به بررسی انسانی دارد؟
Jev برای همین نوع مسئله ساخته شده است.
خروجی ممکن است چیزی شبیه این باشد:
{
  "category": "refund",
  "priority": "high",
  "route": "billing",
  "confidence": 0.94
}
یعنی مدل بهجای تولید توضیحات طولانی، مستقیماً تصمیمی ارائه میکند که نرمافزار بتواند از آن استفاده کند.
آیا Jev واقعاً ۲۰۰ برابر سریعتر از ChatGPT و Claude است؟
اینجا باید با دقت بیشتری به ادعا نگاه کنیم.
TypeSafe اعلام کرده Jev در workloadهایی که برای آن طراحی شده، میتواند حدود ۲۰ تا ۲۰۰ برابر سریعتر از مدلهای Frontier باشد.
Latency اعلامشده برای Jev در بسیاری از این سناریوها حدود:
۷۰ تا ۵۰۰ میلیثانیه
است.
این سرعت بسیار قابل توجه است، اما معنی آن این نیست که Jev در نوشتن مقاله، برنامهنویسی، استدلال علمی یا چت کردن ۲۰۰ برابر بهتر یا سریعتر از ChatGPT است.
مقایسه فقط زمانی معنی دارد که هر دو مدل برای یک تصمیم ساختاریافته مشابه استفاده شوند.
عدد ۲۰۰ برابر از کجا آمده است؟
TypeSafe چند Workflow واقعی را برای ارزیابی مدلها طراحی کرده است؛ از جمله:
- مدیریت رخدادهای امنیتی
- بررسی Agent Traceها
- پردازش Invoice
- مسیردهی درخواستهای Customer Service
در برخی از این سناریوها Jev نسبت به بعضی مدلهای بزرگ اختلاف زمان بسیار زیادی دارد.
اما این اعداد بسته به مدلی که با Jev مقایسه میشود، تغییر میکنند.
برای مثال در یکی از ارزیابیهای منتشرشده، Jev حدود ۰.۴ ثانیه برای هر Case زمان نیاز داشت، در حالی که بعضی مدلهای زبانی بزرگ بین حدود ۱۰ تا نزدیک ۸۰ ثانیه زمان مصرف میکردند.
بنابراین تیتر «۲۰۰ برابر سریعتر» میتواند در یک Benchmark خاص درست باشد، اما نباید آن را به تمام کاربردهای هوش مصنوعی تعمیم داد.
آیا Jev واقعاً صدها برابر ارزانتر است؟
قیمت رسمی اعلامشده برای Jev یکی از جذابترین بخشهای آن است.
TypeSafe قیمت ورودی را:
۰.۰۴۲ دلار به ازای هر یک میلیون توکن ورودی
اعلام کرده است.
یعنی حدود:
۴۲ دلار به ازای یک میلیارد توکن ورودی
و طبق اعلام شرکت، هزینه خروجی نیز فعلاً صفر است.
این رقم برای سرویسهای Backend با حجم بسیار زیاد درخواست، واقعاً عدد بسیار پایینی محسوب میشود.
پس ادعای ۴۰۰ برابر ارزانتر درست است؟
باز هم پاسخ بستگی به مدل مقایسهشده دارد.
اگر Jev را با یکی از گرانترین مدلهای Frontier در Workflow خاص TypeSafe مقایسه کنید، اختلاف هزینه میتواند به چند صد برابر برسد.
اما اگر آن را با یک مدل کوچک و ارزانتر مقایسه کنید، فاصله بسیار کمتر خواهد بود.
بنابراین عبارتهایی مثل:
«Jev همیشه ۴۰۰ برابر ارزانتر از ChatGPT است»
دقیق نیستند.
عبارت صحیحتر این است:
Jev در برخی وظایف تصمیمگیری ساختاریافته میتواند یک تا دو مرتبه بزرگی سریعتر و ارزانتر از استفاده از یک LLM بزرگ باشد.
نتایج Benchmarkها چطور بوده است؟
در Benchmarkهای اولیه TypeSafe، Jev در چهار Workflow داخلی شرکت به میانگین Accuracy نزدیک به ۶۸ درصد رسیده است.
این عدد تقریباً همسطح برخی مدلهای متوسط LLM بوده، اما بعضی مدلهای Frontier قویتر Accuracy بالاتری ثبت کردهاند.
نکته مهم این است که مزیت اصلی Jev در این Benchmarkها بالاترین Accuracy مطلق نیست.
مزیت اصلی آن ترکیب این سه ویژگی است:
- Latency بسیار پایین
- هزینه بسیار پایین
- خروجی ساختاریافته قابل استفاده مستقیم در نرمافزار
یک نکته مهم درباره Benchmarkهای Jev
بخش بزرگی از اعداد اولیه منتشرشده درباره Jev توسط خود TypeSafe اندازهگیری شدهاند.
این موضوع به معنی نادرست بودن نتایج نیست، اما برای قضاوت قطعی باید Benchmarkهای مستقل بیشتری منتشر شوند.
در روزهای ابتدایی عرضه، هنوز حجم ارزیابی مستقل Jev بهاندازه مدلهایی مانند GPT یا Claude نیست.
بنابراین بهتر است اعداد تبلیغاتی را به شکل:
«نتایج اولیه اعلامشده توسط سازنده»
در نظر بگیریم، نه حقیقت قطعی درباره تمام سناریوهای واقعی.
آیا Jev جایگزین ChatGPT یا Claude است؟
خیر.
این شاید مهمترین سوءبرداشت درباره Jev باشد.
ChatGPT و Claude مدلهایی هستند که برای کارهایی مانند:
- مکالمه
- تولید متن
- تحقیق
- استدلال پیچیده
- کدنویسی
- خلاصهسازی
- تولید محتوا
طراحی شدهاند.
Jev اساساً محصول دیگری است.
Jev برای مواقعی مناسب است که نرمافزار باید از بین مجموعهای از گزینههای مشخص، یک تصمیم سریع بگیرد.
یک مثال ساده برای درک تفاوت Jev و ChatGPT
فرض کنید از ChatGPT بپرسید:
یک استراتژی بازاریابی برای فروشگاه اینترنتی من بنویس.
ChatGPT میتواند تحقیق کند، استدلال ارائه دهد و یک استراتژی چندبخشی بنویسد.
Jev برای این کار طراحی نشده است.
اما فرض کنید ۵۰۰ هزار Lead دارید و باید برای هرکدام تصمیم بگیرید:
- High Priority
- Medium Priority
- Low Priority
اینجا Jev میتواند انتخاب بسیار منطقیتری باشد.
Jev متن تولید نمیکند
یکی از عجیبترین تفاوتهای Jev با LLMهای معمول این است که هدف آن تولید متن آزاد نیست.
TypeSafe میگوید خروجیها باید از قبل توسط Developer تعریف شوند.
برای مثال:
["fraud", "safe", "needs_review"]Jev باید یکی از همین گزینهها را انتخاب کند و احتمال هر گزینه را ارائه دهد.
این محدودیت در ظاهر یک ضعف است، اما دقیقاً همان چیزی است که Jev را برای Backend نرمافزارها جذاب میکند.
آیا Jev واقعاً Hallucination ندارد؟
یکی از ادعاهای تبلیغاتی TypeSafe این است که Jev نمیتواند Hallucinate کند.
این جمله بدون توضیح میتواند گمراهکننده باشد.
آنچه از نظر فنی درست است این است که Jev نمیتواند یک خروجی خارج از Schema تعریفشده تولید کند.
اگر گزینهها فقط این سه مورد باشند:
approve
reject
review
مدل نمیتواند ناگهان یک پاراگراف نامرتبط یا مقدار دیگری تولید کند.
در نتیجه خطاهای Structured Output یا Type Error میتوانند عملاً با طراحی سیستم حذف شوند.
اما این به معنی آن نیست که:
Jev هیچوقت تصمیم اشتباه نمیگیرد.
مدل همچنان میتواند گزینه نادرست را انتخاب کند.
به همین دلیل Confidence Score و Calibration اهمیت زیادی دارند.
Confidence Score چه کاربردی دارد؟
یکی از ویژگیهای مهم Jev این است که فقط جواب نمیدهد؛ میزان اطمینان خود را نیز ارائه میکند.
مثلاً:
{
  "fraud": 0.91,
  "safe": 0.06,
  "review": 0.03
}
یک توسعهدهنده میتواند قانونی تعریف کند که:
- اگر Confidence بالاتر از ۹۰٪ بود، سیستم خودکار تصمیم بگیرد.
- اگر بین ۶۰ تا ۹۰٪ بود، بررسی بیشتری انجام شود.
- اگر کمتر از ۶۰٪ بود، تصمیم به انسان منتقل شود.
این ویژگی Jev را برای Automationهای حساس جذابتر میکند.
Jev برای چه کاربردهایی مناسب است؟
سناریوهایی که Jev برای آنها طراحی شده معمولاً تعداد بسیار زیادی تصمیم کوچک و تکراری دارند.
برای مثال:
- تشخیص Fraud
- Route کردن Ticketهای پشتیبانی
- اولویتبندی Leadهای فروش
- طبقهبندی Invoiceها
- اعتبارسنجی دادهها
- Content Moderation
- انتخاب ابزار مناسب توسط AI Agent
- تصمیمگیری درباره اجرای API
- بررسی Eventهای امنیتی
- دستهبندی دادههای ورودی
Jev میتواند برای AI Agentها بسیار مهم باشد
یکی از جذابترین کاربردهای احتمالی Jev مربوط به Agentهای هوش مصنوعی است.
یک Agent ممکن است در هر مرحله مجبور باشد تصمیم بگیرد:
- کدام ابزار را اجرا کند؟
- مرحله بعد چیست؟
- آیا نتیجه قابل اعتماد است؟
- آیا نیاز به دخالت انسان وجود دارد؟
استفاده از یک مدل Frontier بزرگ برای هر تصمیم کوچک میتواند هم کند و هم گران باشد.
در چنین معماریای میتوان از یک LLM بزرگ برای کارهای پیچیده و از Jev برای تصمیمهای سریع و تکراری استفاده کرد.
ترکیب Jev با LLMها شاید مهمتر از رقابت با آنها باشد
احتمالاً نگاه درست به Jev این نیست که بپرسیم:
Jev بهتر است یا ChatGPT؟
سؤال جالبتر این است:
چطور میتوان Jev و مدلهای زبانی بزرگ را در یک سیستم با هم ترکیب کرد؟
برای مثال:
LLM: تحلیل مسئله پیچیده
Jev: انتخاب مسیر بعدی
LLM: تولید پاسخ
Jev: بررسی اینکه پاسخ باید منتشر، اصلاح یا برای انسان ارسال شود
چنین معماریهایی میتوانند هزینه و Latency سیستمهای مبتنی بر هوش مصنوعی را کاهش دهند.
ادعای «ردیابی هر فرد روی کره زمین» چیست؟
همزمان با وایرال شدن Jev، ادعاهای عجیبی نیز در شبکههای اجتماعی منتشر شده است.
برای مثال بعضی پستها آن را شبیه یک سیستم جاسوسی معرفی کردهاند که میتواند افراد را در لحظه ردیابی کند یا در چند ثانیه هر شخصی را در دنیا پیدا کند.
هیچ مدرک معتبری برای چنین ادعاهایی وجود ندارد.
Jev یک مدل تصمیمگیری و طبقهبندی برای نرمافزار است.
توانایی مدل هوش مصنوعی با دسترسی آن به دادهها دو موضوع کاملاً متفاوت هستند.
یک مدل بدون دسترسی قانونی به دادههای مکانی، دوربینها، اپراتورها یا دیتابیسهای خارجی نمیتواند به شکل جادویی موقعیت افراد را پیدا کند.
پس چرا Jev مهم است؟
Jev شاید برای کاربران عادی به اندازه معرفی یک ChatGPT جدید هیجانانگیز نباشد، اما برای توسعهدهندگان میتواند ایده مهمی باشد.
بخش بزرگی از نرمافزارهای واقعی به تولید مقاله و مکالمه نیاز ندارند.
آنها به میلیونها تصمیم کوچک نیاز دارند.
مثلاً:
این تراکنش مشکوک است یا نه؟
این مشتری به کدام تیم منتقل شود؟
آیا این Agent باید API بعدی را اجرا کند؟
این درخواست نیاز به بررسی انسان دارد؟
اگر مدلی بتواند این تصمیمها را با Latency بسیار پایین و هزینه ناچیز انجام دهد، میتواند روی معماری نسل بعدی نرمافزارهای AI تأثیر قابل توجهی داشته باشد.
چقدر باید به ادعاهای Jev اعتماد کنیم؟
در حال حاضر بهتر است بین سه دسته اطلاعات تفاوت بگذاریم:
مواردی که مشخص و قابل تأیید هستند
- Jev محصول واقعی TypeSafe AI است.
- Diogo Almeida سابقه فعالیت در OpenAI دارد.
- Jev برای Structured Decision ساخته شده است.
- مدل Free-Form Chatbot نیست.
- قیمت رسمی اعلامشده بسیار پایین است.
- Latency گزارششده در حد صدها میلیثانیه است.
مواردی که فعلاً بیشتر بر Benchmarkهای TypeSafe تکیه دارند
- ۲۰۰ برابر سریعتر بودن
- ۴۰۰ برابر ارزانتر بودن
- برتری در Workflowهای خاص نسبت به تمام مدلهای Frontier
ادعاهایی که پایه معتبری ندارند
- جایگزینی کامل ChatGPT و Claude
- برتری در تمام کاربردهای هوش مصنوعی
- توانایی جاسوسی یا ردیابی جهانی افراد
- اینکه مدل هیچوقت تصمیم اشتباه نمیگیرد
آیا Jev آینده هوش مصنوعی است؟
هنوز برای چنین نتیجهگیریای زود است.
اما ایده پشت Jev قابل توجه است.
چند سال اخیر صنعت هوش مصنوعی بیشتر روی ساخت مدلهایی تمرکز داشت که بتوانند تقریباً هر کاری انجام دهند.
TypeSafe مسیر متفاوتی را امتحان میکند:
بهجای یک مدل بسیار بزرگ برای همه کارها، یک مدل فوقسریع و ارزان برای یک نوع مشخص از هوش.
اگر این رویکرد در مقیاس واقعی موفق شود، ممکن است در آینده نرمافزارها از ترکیبی از چند نوع مدل استفاده کنند:
- مدل بزرگ برای Reasoning
- مدل کوچک برای Classification
- مدل System One برای تصمیمهای سریع
- مدل Vision برای تصویر
- مدل Speech برای صدا
در چنین آیندهای سؤال دیگر «بهترین مدل دنیا چیست؟» نخواهد بود؛ بلکه سؤال اصلی این است که:
بهترین مدل برای این وظیفه مشخص چیست؟
چطور به Jev دسترسی پیدا کنیم؟
TypeSafe در زمان معرفی Jev دسترسی Early Access را آغاز کرده و توسعهدهندگان را بهتدریج وارد سرویس میکند.
بنابراین برخلاف بعضی مطالب شبکههای اجتماعی، موضوع فقط یک پروژه تحقیقاتی یا دموی مفهومی نیست و شرکت در حال ارائه دسترسی اولیه به توسعهدهندگان است.
برای وضعیت جدید دسترسی، قیمت و مستندات API بهتر است مستقیماً وبسایت رسمی TypeSafe AI را بررسی کنید؛ چون شرایط Early Access میتواند سریع تغییر کند.
جمعبندی؛ Jev انقلاب است یا هیاهوی شبکههای اجتماعی؟
پاسخ جایی بین این دو قرار دارد.
Jev یک پروژه واقعی و از نظر فنی جالب است.
سرعت پایین Latency، قیمت بسیار کم و مدل خروجی Typed میتواند آن را برای Automation و Backend نرمافزارها بسیار کاربردی کند.
اما مقایسه مستقیم Jev با ChatGPT یا Claude بدون توضیح نوع Task اشتباه است.
Jev قرار نیست مقاله بنویسد، با شما گفتگو کند یا جایگزین یک مدل Reasoning بزرگ شود.
وظیفه آن سادهتر اما در بسیاری از نرمافزارها بسیار مهم است:
تصمیمهای کوچک، سریع، ارزان و قابل استفاده مستقیم توسط نرمافزار.
اگر Jev بتواند نتایج اولیه خود را در Benchmarkهای مستقل و محیطهای Production نیز حفظ کند، احتمالاً مهمترین اثر آن نه در اپلیکیشنهای چت، بلکه در زیرساخت نرمافزارهای هوشمند و AI Agentها دیده خواهد شد.
اخبار و تحلیل هوش مصنوعی در معین گیفت
در معین گیفت جدیدترین مدلها و ابزارهای هوش مصنوعی را فقط براساس تیترهای وایرال بررسی نمیکنیم؛ تلاش میکنیم تفاوت بین ادعاهای تبلیغاتی، Benchmarkها و کاربرد واقعی هر فناوری را مشخص کنیم.
اگر ابزارهایی مانند ChatGPT، Claude، Gemini، Grok و مدلهای جدید هوش مصنوعی را دنبال میکنید، میتوانید آموزشها و تحلیلهای بیشتر را در بخش هوش مصنوعی معین گیفت مطالعه کنید.